Domain ewdi.de kaufen?
Wir ziehen mit dem Projekt
ewdi.de um.
Sind Sie am Kauf der Domain
ewdi.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain ewdi.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Festo - Marke für Technologie, Innovation, Bildung, Wissen und Verantwortung, Fachbücher von Patricia PiekenbrockWas ist das Wesen einer Marke? Wie lässt es sich erfassen und was zeichnet es aus? Logos, Farben, Formen, Schriftzüge - natürlich soll eine Marke auf den ersten Blick erkennbar und zugleich unverwechselbar sein. Aber was macht eine Marke tatsächlich lebendig und vor allem zukunftsfähig in einer Welt, die sich zwischen analogem Klimawandel und digitaler Transformation bewegt? Es sind Menschen, die die Marke Festo prägen. Eingebettet in einer global agierenden Weltgemeinschaft sind sie Markenbotschafter eines lebendigen Netzwerks. Ein grosses Wort, das Verantwortung birgt. Denn Eigenschaften einer Marke werden nur dann wahrnehmbar, wenn sie zur kulturellen Substanz eines Unternehmens gehören. So prägt die Marke auch den Menschen. Wo steht die Marke Festo und wo möchte sie hin? Ziel des Familienunternehmens ist es, nachhaltige Lösungen für Mensch, Tier und Umwelt zu entwickeln und auf den Weg in eine verantwortungsvolle Zukunft zu bringen. Um dieses Markenversprechen einzulösen, setzt Festo auf die Dimensionen Technologie, Innovation, Bildung, Wissen und Verantwortung.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Linke Daten, Rechte Daten, Sachbücher von Tin FischerDas Buch "Linke Daten, Rechte Daten" von Tin Fischer bietet eine tiefgehende Analyse darüber, wie Daten und Statistiken je nach politischer Perspektive unterschiedlich interpretiert werden können. Fischer, ein erfahrener Datenjournalist, beleuchtet die Mechanismen, durch die die öffentliche Meinung beeinflusst wird, und stellt provokante Fragen zu Themen wie Migration, soziale Gerechtigkeit und Umwelt. Durch zahlreiche Beispiele zeigt er auf, dass die Wahrheit oft im Auge des Betrachters liegt und dass die Interpretation von Daten stark von den eigenen Überzeugungen abhängt. In einer Zeit, in der Statistiken als vermeintlich objektive Darstellungen der Realität gelten, regt dieses Buch dazu an, kritisch zu hinterfragen, was wir sehen und wie wir es interpretieren. Es ist sowohl erhellend als auch unterhaltsam und bietet wertvolle Einsichten für alle, die sich mit der Rolle von Daten in der Gesellschaft auseinandersetzen möchten.25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
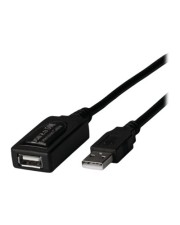
EFB Elektronik Kabel USB2.0 5m A St/A Bu Repeaterkabel Digital/Daten 5 m (K5263.5V3)Produktbeschreibung: EFB-Elektronik - USB-Verlängerungskabel - USB zu USB - 5 m, Typ: USB-Verlängerungskabel, Besonderheiten: Aktives Kabel, Anwendungs-spezifischer integrierter Kreis (ASIC), Länge: 5 m, Anschluss: 4-polig USB Typ A - männlich, Stecker (zweites Ende): 4-polig USB Typ A - weiblich16,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie können Webcrawler verwendet werden, um Daten aus dem Internet zu sammeln und zu analysieren?
Webcrawler sind automatisierte Programme, die das Internet nach bestimmten Informationen durchsuchen. Sie können verwendet werden, um Daten wie Texte, Bilder oder Links von Websites zu sammeln. Die gesammelten Daten können dann analysiert werden, um Trends, Muster oder Informationen zu extrahieren. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Die Resilienz als neue Anforderung des Rechts der Daten- und IT-Sicherheit, Fachbücher von Christoph WernerDie Resilienz als neue Anforderung des Rechts der Daten- und IT-Sicherheit: Eine Untersuchung anhand der exemplarischen Betrachtung kritischer, personalisierter Dienste.124,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Festo - Marke für Technologie, Innovation, Bildung, Wissen und Verantwortung, Fachbücher von Patricia PiekenbrockWas ist das Wesen einer Marke? Wie lässt es sich erfassen und was zeichnet es aus? Logos, Farben, Formen, Schriftzüge - natürlich soll eine Marke auf den ersten Blick erkennbar und zugleich unverwechselbar sein. Aber was macht eine Marke tatsächlich lebendig und vor allem zukunftsfähig in einer Welt, die sich zwischen analogem Klimawandel und digitaler Transformation bewegt? Es sind Menschen, die die Marke Festo prägen. Eingebettet in einer global agierenden Weltgemeinschaft sind sie Markenbotschafter eines lebendigen Netzwerks. Ein grosses Wort, das Verantwortung birgt. Denn Eigenschaften einer Marke werden nur dann wahrnehmbar, wenn sie zur kulturellen Substanz eines Unternehmens gehören. So prägt die Marke auch den Menschen. Wo steht die Marke Festo und wo möchte sie hin? Ziel des Familienunternehmens ist es, nachhaltige Lösungen für Mensch, Tier und Umwelt zu entwickeln und auf den Weg in eine verantwortungsvolle Zukunft zu bringen. Um dieses Markenversprechen einzulösen, setzt Festo auf die Dimensionen Technologie, Innovation, Bildung, Wissen und Verantwortung.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Linke Daten, Rechte Daten, Sachbücher von Tin FischerDas Buch "Linke Daten, Rechte Daten" von Tin Fischer bietet eine tiefgehende Analyse darüber, wie Daten und Statistiken je nach politischer Perspektive unterschiedlich interpretiert werden können. Fischer, ein erfahrener Datenjournalist, beleuchtet die Mechanismen, durch die die öffentliche Meinung beeinflusst wird, und stellt provokante Fragen zu Themen wie Migration, soziale Gerechtigkeit und Umwelt. Durch zahlreiche Beispiele zeigt er auf, dass die Wahrheit oft im Auge des Betrachters liegt und dass die Interpretation von Daten stark von den eigenen Überzeugungen abhängt. In einer Zeit, in der Statistiken als vermeintlich objektive Darstellungen der Realität gelten, regt dieses Buch dazu an, kritisch zu hinterfragen, was wir sehen und wie wir es interpretieren. Es ist sowohl erhellend als auch unterhaltsam und bietet wertvolle Einsichten für alle, die sich mit der Rolle von Daten in der Gesellschaft auseinandersetzen möchten.25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie können Webcrawler verwendet werden, um Daten aus dem Internet zu sammeln und zu analysieren?
Webcrawler sind automatisierte Programme, die das Internet nach bestimmten Informationen durchsuchen. Sie können verwendet werden, um Daten wie Texte, Bilder oder Links von Websites zu sammeln. Die gesammelten Daten können dann analysiert werden, um Trends, Muster oder Informationen zu extrahieren. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
EFB Elektronik Kabel USB2.0 5m A St/A Bu Repeaterkabel Digital/Daten 5 m (K5263.5V3)Produktbeschreibung: EFB-Elektronik - USB-Verlängerungskabel - USB zu USB - 5 m, Typ: USB-Verlängerungskabel, Besonderheiten: Aktives Kabel, Anwendungs-spezifischer integrierter Kreis (ASIC), Länge: 5 m, Anschluss: 4-polig USB Typ A - männlich, Stecker (zweites Ende): 4-polig USB Typ A - weiblich16,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Latenz: Entwicklung und Behandlung, FachbücherDas Latenz-Kind wagt normalerweise den Sprung aus der Familie und beginnt in der Schule zu lernen. Doch in der Latenz offenbaren sich dann Probleme und Konflikte aus vorangegangenen Entwicklungsschritten, die nun psychotherapeutisch bearbeitet werden müssen. Beiträge von: Dieter Bürgin, Yecheskiel Cohen, Manfred Endres, Elke Fietzek, Michael Günter, Hans Hopf, Ellen Lang-Langer, Dagmar Lehmhaus, Nick Midgley, Maria Mögel, Jack Novick, Kerry Kelly Novick, Fernanda Pedrina, Catharina Salamander, Sieglinde Tömmel.29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
AEG Starthilfekabel Sicherheit SP25Das AEG Starthilfekabel mit StartProtect-Technologie Das AEG Starthilfekabel SP 25 "StartProtect" hat ein rotes und ein schwarzes Kabel mit vollisolierten Best-Contact-Polklemmen. Die Kabel mit Kupfer-Aluminium-Technologie entsprechen dem Leitwert eines26,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.